前面已经写过两篇跟 Cache 有关的 AI 安全文章,第一篇主要研究的是 LLM 中的 KV Cache 《从原理到攻击:KV Cache 安全问题与跨会话泄漏实验》
这里简单回顾一下,详细的可以看我发的链接https://www.yijinglab.com/specialized/20260908111512
Cache 本来是为了性能,所以之前已经计算过的东西就不要重新计算,然后当不同请求开始复用状态,Cache Hit或者Miss就会出现时间差,攻击者可以观察时间
差来达到攻击的目的
第二篇研究的是 Diffusion Model 中的 Approximate Cache《从原理到攻击:Approximate Cache 安全问题与文生图缓存攻击实验》https://mp.weixin.qq.com/s/rSSBu6Z_dPrKDWvHSuVcEQ
它在传统 Cache 可能下又往前走了一步,传统的cache可能就要求 A==B 才能复用,而Approximate Cache 则可能只需要,Similarity(A, B) > threshold
就可以开始复用中间状态;于是 Cache 的安全问题从,相同请求之间的状态共享,进一步扩展到了语义相似请求之间的状态共享,然后就出现了所谓的
Covert Channel,Prompt Stealing,cache Poisoning这些攻击,说到底还是共享状态安全问题的三个不同表现
写完这两篇之后,我就有个问题,都是针对KV cache进行攻击,有没有对其进行修复或者防御的?
比如说直接不要共享 cache,但是如果真的这么干,就相当于为了安全,直接把性能优化关掉,这显然不是一个好办法
然后我就看到一篇 2026 年的论文,讲的就是怎么如何修复cache安全问题
cache安全问题这里就不再细说,前面两篇公众号文章已经写得很清楚了,可以跳到前面两篇
如果 cache 只在一个用户自己的会话里复用,安全问题其实没那么严重,毕竟自己观察自己,算什么租户隐私泄漏嘛
但是真正麻烦的是在多租户这里,如果说多个User都共用同一个 LLM Serving,那么为了最大化 Cache Hit Rate,服务器可能维护一个共享的 Prefix Cache
比如说,user A 创建 cache,然后user B 可以命中,于是user B 观察到延迟变化,这样 B 就获得了一个Oracle
这个oracle 可以简单理解为,攻击者可以不断向系统提问,而系统虽然不会直接回答秘密,却会通过某个现象间接回答;oracle在本文后面会一直出现,记住这个
概念;那既然说到了oracle,就不得不提一个问题,攻击者利用cache Hit,去少执行了一部分 Prefill,然后TTFT 变短,从而可以观察到Timing;那么是不是直接
把timing给它隐匿掉就可以了?比如说给响应时间增加一点噪声,这样攻击者就不好判断通过timing进行一个判断了
这么想,好像这个思路是可以的;但是加了相应时间其实也会影响LLM的正常相应速度的,所以这个办法只是治标不治本
最关键的还是要解决为什么攻击者自己发送的一个请求,能够命中另外一个用户创建出来的 Cache?
我们来拆解一下,先假设服务器维护一个非常简单的 Prefix Cache,把复杂实现全部去掉,可以简单理解为,cache[key] = kv_state
当新的请求到来之后,会去计算cache key,然后查cache,如果说找到了hit,就直接复用之前已经计算过的 KV State
问题是,这个cache Key到底怎么计算?在 Prefix cache 里面,Key 的主要依据是,Token Content
例如为了方便理解,可以粗略写成,key = Hash(tokens),我们假设block_size = 16
那么第一个block,token0~token15,h0 = H(tokens[0:16])
然后下一个 Block 又和前一个 Hash 连起来,h1 = H(h0 || tokens[16:32]) ,依次往下类推
如果两个请求前面的 Token 完全一样,那么前面生成出来的 Hash 也完全一样。
于是 Request B 可以直接复用 Request A 已经算好的 KV,这就是性能优化,同时也是安全问题
说得直白一点,cache Key 根据 Token 序列计算,却没有绑定用户主体,因此不同用户可以解析到彼此创建的 cache Entry
例子这里就不举了,可以去看我在前言贴出来的两篇,里面都有
整个cache可以看成一个类似字典的东西,比如说这样
cache = {
    hash1: KV_State_1,
    hash2: KV_State_2,
    hash3: KV_State_3
}
当所有的user去访问同一个cache,大概就会类似下面这样

由图我们就可以很直观看到,只要key A == key B,UserB就有可能命中了UserA的东西;
那么由图也可以很好看出解决办法,那就是把Global KV cache根据用户拆分对应用户的cache,类似下图

此时即使,Prompt_A == Prompt_B,A 和 B 也不会命中同一个 cache;这个思想,就是 KVGov这个防御KV cache攻击最核心的东西
这里要注意一点,虽然我一直在说user A B C等等之类的,但其实user 不是完全就是指用户,它更具体地说应该是系统中应该拥有独立安全边界的身份主体
比如说租户啊,组织啊,还有API,或者是安全域等等之类的
比如说一个企业SaaS,Company A,Company B和Company C,那么完全可以Company作为一个User,或者更准确的用词应该是Principal
那么同一个公司的请求,比如说Compan A user 1和Company A user 2,可以根据策略共享 cache
但是捏Company A和Company B之间必须隔离
所以cache 的共享范围应该和系统的安全边界一致
而KVGov就是把你是谁加入 Cache Key,它的核心机制就是HMAC-Keyed Namespace Isolation
我们刚刚提到普通情况的CacheKey = Hash(Prompt Tokens)是这样表示的,而KVGov则是
CacheKey=
Hash(
    Principal-Specific Salt
    +
    Prompt Tokens
)
这个 Principal-Specific Salt 怎么来?其实是
σp = HMAC_K(secret, principal_id)其中principal_id代表当前安全主体,而K是服务器端持有的 Secret
然后第一个 Block 的 Hash 就由之前的h0 = H(tokens[0:16]) 变成下面这样
h0 = H(
    σp || tokens[0:B]
)
后续 Block 继续链式计算,这样听起来感觉很抽象,所以我们举个例子来说
受害者A:
salt_A=
HMAC(
    server_secret,
    "victim_A"
)
攻击者B:
salt_B=
HMAC(
    server_secret,
    "attacker_B"
)
现在即使 prompt A == Prompt B,但是计算的却是salt_A = HMAC(server_secret, principal_A),受害者 H(salt_A || prompt),salt_B = HMAC(server_secret, principal_B),攻击者 H(salt_B || prompt)
注意这里的||并不是与或运算的意思,而是连接的意思,比如说salt_A = "abc123" prompt = "hello",则salt_A || prompt就是"abc123hello" 这个意思的
所以CacheKey_A != CacheKey_B
也就是即使Prompt 一模一样,但缓存空间不同
这样攻击者即使100% 猜对 Victim 的 Prompt,也不会出现kv cache攻击
攻击者自己的 Probe 所得到的 Key 与 受害者的 Key 在密码学意义上不同,因此攻击者只会填充自己的cache空间;
从攻击者角度看,受害者的Cache 对他的 Timing Fingerprint 表现为 all-MISS
看到这里,都会有一个问题,那就是为什么不能把User_ID加进去不就得了,根本不需要HMAC,直接
Hash(
    user_id || prompt
)
从让不同 Principal 的 Key 不一样这个直觉目标来看,好像确实也能产生不同 Key
但论文选择的是:
HMAC(
    server_secret,
    principal_id
)
产生一个攻击者无法预测的 Salt,这里的意义在于principal_id,它未必是秘密,比如说tenant_123这样质朴的用户名,甚至可能是可以被其他用户知道的
但server_secret,只有服务端拥有,因此攻击者即使知道,受害者的Principal ID,也不能自己算出σvictim
他就无法构造受害者的Namespace去命中的 Cache Key
讲到这里,安全问题好像解决了,但是别忘了之前有KV cache就是要来解决性能缓存的问题的,那现在这样分隔,难道不会增加性能的开销吗?性能的问题又怎么
办呢?假设一个企业 AI 系统每个 User 的 Prompt 都是:
[2000 tokens System Prompt]+[User Private Input]前面的2000 tokens System Prompt,其实所有用户完全一样,比如说那些常见的提示词
你是个专业的财政助手balabalabala的
你必须遵守xxxx政策之类的..
你必须使用xxxx工具...
只有最后private input这一点不同,基于如此如果从Block 0,就加入 Principal Salt,User A 2000 Token System Prompt和User B 2000 Token System Prompt
明明内容完全一样,却不能共享任何 Prefix Cache,这就变成了为了安全,把跨租户缓存优化基本关掉
所以肯定不能这样一刀切,需要精准定位
我们假设有两个不一样的prompt
User A:
[ Shared System Prompt           ]
[ Shared System Prompt           ]
[ Shared System Prompt           ]
[ Shared System Prompt           ]
---------------------------------
[ account = 12345678             ]
[ private content A              ]


User B:
[ Shared System Prompt           ]
[ Shared System Prompt           ]
[ Shared System Prompt           ]
[ Shared System Prompt           ]
---------------------------------
[ account = 87654321             ]
[ private content B              ]
可以明显看到,前半部分完全一样;后半部分才开始出现用户差异
前面的 Block0~Block(K-1)保持Global Shared,到了Block k
才执行:
H(
    σp||previous_hash||tokens
)
然后因为 Hash Chain 的传播:
Block k
加入 Principal Salt
       ↓
Block k+1
依赖 Block k
       ↓
Block k+2
依赖 Block k+1
所以从Block k往后的所有 Block 都自动变成Principal Private
边界之前的 Block 保持共享,到了边界再注入 σp,后面的 Chain 全部进入 Principal私人的Namespace

这样做就会变成公共内容继续共享,私人内容开始隔离;这就会比全部共享或者全部隔离等一刀切的方法来得精细多
OK,那现在新的问题来了,就是这个边界到底应该放在哪里?也就是从哪个 Block 开始加 Salt?
例如说,第一个包含 private input的 Block可以作为 Boundary
或者这样规定,System Prompt 可以跨 Tenant 共享,User Input 不允许共享
那么,也就是System Prompt 结束的位置就可以作为边界
这也是为什么KVGov,它需要知道认证的主体和共享的策略,而这些信息并不一定天然存在于底层 Serving Engine 里面
前面已经讲完 KVGov 的核心设计,那接下来回答为什么一个 HMAC Salt可以同时防住几种看起来完全不同的攻击?
这里选择了三个已有攻击PROMPTPEEK,EarlyBird和InputSnatch;这三个攻击看起来方法完全不同,但是 KVGov 的观点是:
它们其实都在使用同一个跨 Principal Cache Oracle
假设攻击者已经有一组候选 Prompt[P1~Pn],然后挨个向系统发送 Probe
如果某个 Prompt 已经存在于共享 Cache,所以它的相应时间会比较短;反之则时间较长
于是攻击者最终可能得到一个类似这样的时间向量[50, 50, 5, 50, 5, 5, 50, ...]
假设:5 ms ≈ Hit,50 ms ≈ Miss
那么这个向量实际上已经隐含了,[MISS, MISS, HIT, MISS, HIT, HIT, MISS ...],类似于一个cache指纹
PROMPTPEEK 再把攻击者观察到的指纹和受害者的候选指纹做相关性分析,从而进行判断
那么 KVGov 怎么防?加了 Principal Namespace 以后,受害者的 P1即使之前已经进入受害者空间,攻击者后来再发送P1
查询的也是攻击者本身的空间,所以第一次仍然是MISS
于是攻击者看到的时间向量就会变成[MISS, MISS, MISS, MISS, MISS, ...]
也就是不管受害者到底缓存了什么东西攻击者的观察结果基本不变
论文对此描述得很直接:HMAC Salt 后,攻击者无法解析 Victim 的 Cache Entry,观察到的是 all-MISS Fingerprint,因此其 Pearson Correlation 接近 0
EarlyBird 的攻击方式则和 PROMPTPEEK 不太一样,它更接近传统 Cache Timing Attack
简单来说就是知道前缀,然后猜下一个token,观察相应时间,如果短说明猜对了
vLLM 0.26.0 V1 Engine,默认 Block Size 是 16
那么攻击者面对的问题就变成了,要连续猜对16个token才能观察到新的Block Hit
对于一些完全自由文本,这个搜索空间确实非常大,但是一些真实企业 Prompt 很多并不是完全自由文本
假设一个企业系统长期使用这样的 文本,Show transactions for account xxxx in September
攻击者实际上已经知道,Show transactions for account
也知道in September,真正未知的可能只有xxxx,比如说8 位数字
如果按照完全自由 Token 计算,搜索空间约为|V|^16 ≈ 10^83
但是如果未知内容只是一个八位账户号10^8,如果还知道银行、分行或者发行方前缀,大概是10^4 ~ 10^6
搜索空间一下就下降了大约 75 个数量级
而且还有更进一步的,假设攻击者本来就已经知道一个具体账号12345678
那么攻击者根本没必要问,“受害者 Prompt 到底是什么?”
他只需要问“12345678 有没有在 Cache 中出现过?”
直接构造类似这种
Show transactions for account 12345678 in September然后 Probe 一次,如果 Hit,说明可能说明目标内容曾经被服务过
InputSnatch 就更加能体现这个问题,它针对的并不只是一种 Cache
它主要有两个放心,一个是Prefix Cache,利用企业 Prompt 往往具有 Template Structure 这一特点,逐字段恢复未知内容
另一个则是,Semantic Cache,根据 Embedding Similarity 对缓存空间进行探索
这里需要特别注意,KVGov 的 HMAC Salt 并不能直接解决 InputSnatch 的 Semantic Cache
因为Prefix Cache 判断的是Key是否相当,所以我们可以给 Key 加 Salt,让Key_A != Key_B
但 Semantic Cache 判断的是Embedding是否相似,例如Similarity(A, B) > threshold
你给 User A 一个 Salt、User B 一个 Salt,并不会让Embedding("dog running in park")和 Embedding("a dog running outside")突然变得不相似的
所以 Semantic Cache 真正需要做的是:
Principal A
    ↓
Retrieval Index A


Principal B
    ↓
Retrieval Index B
KVGov Semantic Cache 必须通过 Principal Partitioning 的方式进行隔离
市面上有其他的防御方式,比如说Noise、Flush、Admission
Noise加噪声,让 Timing Oracle 变模糊,所以对 Timing指纹型的 PROMPTPEEK 很有效
但是最关键的还是Oracle 本身还存在,因此对不依赖 Timing Magnitude 的 Membership Attack 没用
Flush是缩短 Cache 生命周期,但是受害者的Session 活着的时候,攻击窗口依然存在。
Admission是阻止某些 PII Prompt 进入 Cache,但是又不是所有秘密都是 PII
比如:System Prompt Tool Definition Repository Context Enterprise Policy这些也都非常敏感
论文的结论也是,真正承担核心 Privacy Guarantee 的是 HMAC Salt,其他组件更多属于补充防御
前面原理基本已经讲完了,那么这里通过几个简单实验验证一下KVGov最核心的几个结论
原论文的实验比较完整,包括PROMPTPEEK、EarlyBird、InputSnatch三类攻击, 还有消融实验、ORIGAMI以及真实硬件上的TTFT测试
这里就不完全照着论文复现了,而是精简成三个问题:
Cache Hit和Cache Miss之间的Timing差异是否足够明显?
HMAC Namespace Isolation能不能真正切断跨Principal Cache Hit?
完全隔离Cache以后性能会不会损失太大,Boundary Salting能不能缓解这个问题?
Cold TTFT   = 149.6 ms
Cached TTFT = 32.8 ms

Cached / Cold = 0.22
在此基础上加入少量随机抖动,模拟实际LLM Serving环境
实验设置:
Random Seed       = 2026
Candidate Number  = 100
Trials            = 1000

Cache Hit TTFT    = 32.8 ms
Cache Miss TTFT   = 149.6 ms
Base Jitter       = 5 ms
Noise Sigma = 20 ms首先来看整个Cache Timing Attack成立的基础
模拟1000次Cache Hit和1000次Cache Miss以后,得到:

可以看到,Cache Hit和Cache Miss之间存在非常明显的Timing差异,也就是说,攻击者虽然没有权限读取另外一个Tenant的GPU Memory,也不能直接查看另
外一个Tenant的KV Cache,但是只需要观察自己请求的TTFT,就可能得到一个Oracle
所以这里真正泄漏的不是KV Tensor本身,而是Shared Cache的内部状态通过响应时间间接暴露了出来
先假设一个多租户场景,有两个Principal受害者A和攻击者B
系统中存在一个固定模板,Show transactions for account <ACCOUNT_ID> 其中ACCOUNT_ID一共有100个候选值。
受害者首先访问其中一个Account,使对应Prompt进入Cache,之后攻击者依次枚举100个Account,并通过TTFT判断哪个Candidate发生了Cache Hit

从结果可以看到,在Global Cache情况下,Identification ASR = 100%,Victim Cross-Principal Hit = 100%
也就是说,攻击者枚举到受害者使用过的Account时,对应请求会直接命中受害者创建的Cache
攻击者只需要找到最快的响应,就可以反推出Victim曾经访问过哪个Account
接下来加入一个简单的Timing Noise
最终实验结果依上图所示,Identification ASR = 99.4% 和 Victim Cross-Principal Hit = 100%
也就是说Noise并没有改变Cache本身的共享关系,攻击者仍然可以命中Victim创建的Cache
最后加入KVGov最核心的HMAC Namespace Isolation
实验结果如下图 
最重要的Cross-Principal Hit变成:Global Cache = 100%,Noise = 100%和HMAC-Salt = 0%
更关键的指标其实是,Victim Cross-Principal Hit,HMAC-Salt以后,这个值从100%变成了0%。
也就是说,KVGov并不是单纯让Timing变得更加难以观察,
而是直接让Attacker的请求无法解析到受害者的Cache Namespace
前面的实验说明了HMAC-Salt能够解决跨Principal Cache Hit的问题。
但是这里马上又会产生另外一个问题:
如果从第一个Block开始就加入Principal Salt,那么不同Tenant之间是不是完全无法共享Cache了?
假设一个企业LLM Prompt结构如下:
[ 2000 Token Shared System Prompt ]
[  119 Token Private User Input  ]
总长度:
2119 Tokens前面的2000 Token可能只是所有用户都完全相同的System Prompt:
你是一个企业金融助手...
你必须遵守公司的安全策略...
你可以使用以下工具...
真正存在用户差异的只有后面的119 Token
KVGov进一步提出的思路就是,没有必要从Block 0开始Salt
我们可以把Cache划分成我在上面所说的 Global Shared Namespace和Principal Private Namespace
Boundary之前,继续Global Shared
Boundary开始H(σp || previous_hash || tokens)
由于Hash Chain会继续向后传播,所以只需要在Boundary注入一次Principal Salt,后面的所有Block都会自动进入Private Namespace,结果如下图:

三个策略分别得到:
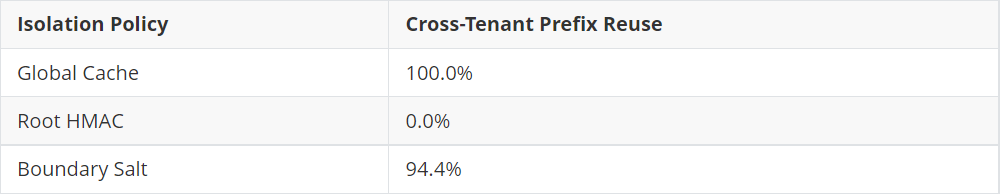
可以很直观地看到,Global Cache 安全性低,性能最好
Root HMAC,安全性高,但完全失去跨Tenant Prefix Reuse
Boundary Salting公共部分继续共享,Private部分完成隔离,因此KVGov实际上并不是简单地为了安全把Cache关掉
而是重新精准分割了哪些要共享,哪些可以不共享
本课程最终解释权归蚁景网安学院
本页面信息仅供参考,请扫码咨询客服了解本课程最新内容和活动