上一篇研究 KV Cache 的时候,我介绍了KV cache攻击,缓存本来只是一个性能优化,它主要就是用来解决大模型推理太贵了,之前已经算过的东西,就尽量不要
重复算的问题,直接把这些东西保存下来,下一次 Attention 的时候继续使用就好了,但是只要这个缓存开始在不同请求甚至不同用户之间复用,它就不再只是性
能问题,而会变成安全问题;攻击者并不用真正读取服务器中的 KV Cache,有的时候只需要观察时间差就可以了,如下
Cache Hit---> 少计算了一部分内容---->响应速度变快----->攻击者观察时间差----->推断缓存中是否存在某些内容
进一步来说,如果缓存中的状态能够被攻击者提前影响,并且之后又被其他用户复用,那么攻击方向就从读取cache,变成了污染 cache
也就是我之前所写的文章里提到的KV Cache Hijacking Poisoning
然后最近看 USENIX Security 2026 的时候,又发现了一篇更有意思的论文
这一次研究的甚至不是 GPT ,Llama 这种语言模型,而是 Stable Diffusion、FLUX 这类文生图模型,但是攻击思想是一致的,基本上都是
为了性能---->共享某些中间状态----->不同用户之间产生间接联系--->原本不存在的攻击面出现,但是两者之间还是略有区别的
研究人员发现,为了让 AI 画图更快而引入的一种 Approximate Cache,也就是近似缓存,它和普通的cache最大的区别就在于
普通 Cache 通常要求输入相同才命中,而 Approximate Cache 甚至只要求输入足够相似
这种设计虽然提高了效率,却也可能削弱不同用户之间的隔离,所以可以被利用来传递秘密,偷 Prompt,甚至污染别人的生成结果
这里虽然涉及到原理,但是不要喧宾夺主,我简要说一下diffusion的工作原理
简单来说就是,全是噪声的图片 ---> Step 1 去噪 ----> Step 2 去噪 ----> Step 3 去噪 ----> ...... ----> Step 30 ---> 最终图片
Prompt 会在这个过程中不断指导去噪,前面的去噪步骤不是完全没有意义的过渡状态,这些中间结果已经包含了一部分生成信息
甚至图片比较早期的布局、结构等特征,就可能已经在中间状态里逐渐形成,而这其中就会涉及到KV 缓存的问题
就比如说,如果别人刚才已经生成过一张和我非常相似的图片,那为什么我一定要从 Step 1 重新算?
用户A 用promptA产生 1 → 2 → 3 → ... → 10 → 11 → ... → 30 中途可能保存10的状态
然后来了用户B ,他的Prompt B 与 A 很相似,所以会直接复用 Step 10 的状态 ...→ 11 → 12 → ... → 30
前面的部分就不用重新计算了,相似度越高,理论上能够复用、跳过的步骤也可以越多
其参考设计会缓存多个阶段的状态,从而按照 Prompt 相似度选择不同程度的复用
传统的cache好理解,可以这么认为,假设缓存里面有key = "hello",那么你访问hello,就可能命中;但是如果访问的是hello world,就可能不会命中
但是 Approximate Cache 不一样,主要还是要纠结一下两个 Prompt 到底多像才算相似?
论文研究的参考系统会把 Prompt 转换为 CLIP Embedding,然后计算新 Prompt 和已有缓存 Prompt 的 cosine similarity
当相似度超过某个 threshold 后,就把它认为是 Cache Hit,打个比方来说
Prompt A的提示词是,A cute golden retriever running through a green park
在高维向量空间里面可能就被编码为 [0.13, -0.41, 0.72, 0.18, ...]
而另一个提示词Prompt B: A happy golden dog running outside on the grass
假设编码为[0.15, -0.39, 0.69, 0.21, ...]
这样就有了两组编码数据,然后计算cosine_similarity(A, B),假设得到0.82,超过系统阈值,所以它们是相似的
注意,这里用户 A 和用户 B 输入的文字压根不是一样的,在传统 Cache 的思维里,A是不等于B的
但在 Approximate Cache 里:Semantic(A) ≈ Semantic(B),所以说Cache(A) 可以被 B 复用
以前的攻击者可能需要猜受害者到底输入了什么字符串?现在只需要向向受害者 Prompt 所在的语义空间靠近就可以了
但是这里可能就会有个问题,高维空间向量,攻击者是看不见的,所以可以怎么攻击?
毕竟别说攻击者了,就是正常用户,也是看不到cache = {prompt1: state1,prompt2: state2,prompt3: state3}这种存储数据的
攻击者没有 root,也没有 GPU 显存读取权限,也没有服务器源码
甚至不知道别的用户生成过什么东西,那这种攻击怎么实现?
可以借鉴一下传统的KV cache攻击是怎么 观察到攻击的
论文里面提出了两种外部观察对象,后面三种攻击全是由这两种组合而来的
这一种很熟悉了吧,就是传统的kv cache攻击,通过去观察相应时间去判断自己的攻击是否有效,这一点详细可以看看我上一篇文章,这里就不再赘述了
https://www.yijinglab.com/specialized/20260908111512
这种攻击就有Diffusion Model这种图片生成模型的特点了,简单来说就如果命中同一cache的图片会长得更像
先假设服务器缓存了,A dog running through a forest 对应的某个中间状态
现在攻击者发送两个不同 Prompt
Prompt A:A golden retriever running in the woods
Prompt B:A dog running quickly in a dark forest
假设它们都命中了同一个 cached state,那么也就是

它们后半部分虽然分别继续生成,但是起点已经共享了一部分信息,所以最终图片可能在,比如说主题位置,布局或者是姿态等等方面上会更加相似
所以攻击者这个时候就有了两种可以观察的攻击窗口了

这样这两种观察对象就可以组合从三种攻击方式
第一个攻击叫Remote Covert Channel,也就是远程隐蔽信道
打个比方,假设有两个人A和B,它们之间没有直接通信的通道,但是两个人都可以访问同一个图片生成服务
那么就可以利用服务器里的 cache 传递信息,因为cache本质上是可以保存状态的
比如说A和B提前约定一个非常罕见的词,Apricity
A如果想传递数字1,那么就向服务器发送一个包含这个词的特殊 Prompt
例如说,A mysterious landscape named Apricity with a dog
如果说这个请求没有命中已有 cache,它的 Prompt 和中间状态就可能被保存
于是服务器里存在这样一种cache
Apricity + dogB再发送,A beautiful scene representing Apricity
注意看,这里因为两个 Prompt 中都有非常特殊的关键词,Apricity,所以语义上更容易靠近A留下的 cache
如果命中了,生成时间下降了,那么B就知道,这个 cache Entry 可能存在
于是规定,HIT=1,MISS=0,这样一位就传出来了
那这里其实就有个问题,为什么光靠响应时间是不够的?因为Approximate Cache 不是,key == key这么简单
而是,similarity > threshold;所以当B发出Apricity的时候
以后即使观察到了 cache Hit,也不能 100% 确定,命中的就是A留下来的东西
有可能刚好碰上其他用户留下的某个相似 Prompt,也就是出现所谓的False Positive
所以论文中再利用了Attack Primitive 2,也就是marker
于是A实际写入,Special Keyword+Marker
B之后首先判断,生成时间是不是足够短,也就是是不是cache hit,紧接着又判断生成图片中有没有出现Marker,也就是是否是当初A留下的cache
于是两种侧信息结合,才确认这就是cache entry
基于如此,就可以愉快地通信了,当然肯定是二进制通信了
比如说双方约定五个关键词,word1,word2,word3,word4,word5,然后二进制是10110
那A只要让word1 → 写 Cache,word2 → 不写,word3 → 写 Cache,word4 → 写 Cache,word5 → 不写
而B只要挨个去探针检测一番,就可以得到,word1 → Hit → 1,word2 → Miss → 0,word3 → Hit → 1,word4 → Hit → 1,word5 → Miss → 0
就会得到10110,就这样两个用户即使没有email,database,共享文件等杂七杂八的东西,也能够通过AI 服务内部的 Cache 状态做到通信
下面是实验复现结果,代码太长太复杂,前置准备东西太多,这里就不一一列举了

实验中发送方通过构造会命中或不命中 approximate cache 的 prompt 来编码二进制信息,接收方可以通过两类侧信道判断每一位:
Cache hit  → 推理跳过部分 denoising steps → 延迟较低
Cache miss → 完整生成                    → 延迟较高
这一点就是我刚刚上述说的
截图中的结果中最重要的结果是,Timing-only accuracy = 100%
说明仅利用远程生成请求的响应时间,就已经可以完整恢复发送方编码的 10-bit 消息
这个攻击首先对 FLUX 的 cache hit / miss 延迟进行了 profiling,确认 cache hit 会产生明显的延迟下降;随后将 bit 1 和 bit 0 分别编码成 cache hit 与 cache
miss,最终成功通过时间差恢复消息,也就是确定了Approximate cache 的命中状态可以形成远程 timing covert channel,攻击者无需访问模型内部状态,仅通
过生成延迟即可传输隐藏信息
这种攻击我觉得是最有意思的,它是在讲能不能把其他用户缓存里的 prompt 偷出来?
毕竟一段经过反复调试prompt本身就具有一定的商业价值
过去的偷prompt的方法无不都需要攻击者要先看到受害者生成出来的图片,但是 CacheExposer 的攻击模型更加有意思,完全不需要那些虚头巴脑的东西
我们知道因为看不见cache,所以无法通过时间差来达到偷prompt的目的,因为攻击者发送的探针不一定命中的是同一个 Prompt
所以这里就结合了Attack Primitive 2
我们先假设Probe A,Probe B和Probe C三者命中了同一个 Cached Prompt,那么根据Attack Primitive 2它们生成的图片结构往往更接近

大概类似这样Group 1有Prompt A,Prompt F,Prompt J;Group 2有Prompt B,Prompt C和Prompt H
然后就有个经典的问题了,有了一堆相似 Prompt,怎么找原始 Prompt?
我们先假设经过聚类得到的如下所示
Probe A:
a medieval warrior in a dark forest
Probe B:
a knight standing between trees at night
Probe C:
fantasy armored warrior inside a forest
Probe D:
a realistic knight surrounded by woodland它们全都命中了,Unknown Cached Prompt X;那么即使不知道 X 是什么,也能得出一个信息
X 在语义空间里,应该同时靠近 A、B、C、D
所以现在变成寻找一个 Embedding E,使得,Similarity(E, A),Similarity(E, B),Similarity(E, C)和Similarity(E, D)
都满足我们从 Cache 行为中观察到的约束
打个比方,凭空猜一个人在哪很难办到,但是只有提供所在位置的地标或者是明显建筑就可以确定其位置
然后根据一组已经确定会命中相同 Cached Prompt 的 Probe,优化这个 E
目标是让E在embedding空间中尽可能满足这些 Probe 对未知目标的相似关系
论文使用 SGD 进行迭代优化,把构造 embedding 与这些 probing prompts 的相似度关系逼近目标 Cache 所表现出的相似关系
最后再用Prompt Recoverer,将高维向量的embedding转换为prompt,整体的攻击思路如下图

下面是实验复现结果,代码跟上述一样就不放了,占地方,直接放结果

该攻击的目标不是直接得到 victim 的图片,而是通过 approximate cache 泄漏的信息,恢复 victim 缓存中的原始 prompt
截图中的 victim prompt 为conceptual art of ....
最终恢复出的 stolen prompt 为highly detailed digital ....
两者的 semantic similarity 为Prompt semantic similarity = 0.7922
虽然没有逐字恢复 at night、classical painting、matte painting 等风格修饰词,但主要语义实体已经被成功恢复
也就足以证明攻击者仅利用 approximate cache 的 timing 信息和 prompt embedding 关系,就可以恢复缓存用户 prompt 的核心语义
前两个攻击基本都是,从 Cache 里面拿信息,接下来这个攻击方向完全反过来了
不再是读取,而是修改;论文称之为CachePoison
如果看过上一篇 KV Cache Hijacking,其实这里应该已经很熟悉了
核心问题就是,如果攻击者能够构造一个特殊的缓存状态,而其他正常用户之后又会复用这个状态,会怎么样?
论文选择了一个很直观的 Payload,Logo
以前的投毒方式攻击者希望以后其他用户生成的图片里面都出现自己想要的东西,比如说Apple logo
最简单的办法似乎是Normal Prompt+Apple Logo
例如A beautiful futuristic city at night,Apple logo 就这么简单
然后让这个 Prompt 进入 Cache,但是这样问题来了
正常用户输入,A beautiful futuristic city at night
攻击者缓存的是A beautiful futuristic city at night,Apple logo
后面多了一个明显的概念,两个 Embedding 的相似度可能因此下降,投毒再强,没人命中也没用。
所以 Cache Poisoning 最大的问题是怎么在写入恶意内容以后,依然保持和正常 Prompt 足够相似
既然刚才已经有CacheExposer,那么就可以找出一些能够代表真实用户 Prompt 的内容
然后将其转换为embedding,然后向 Embedding 中加入Logo Information
但同时又尽量让新的 Embedding,仍然靠近原始 Prompt
论文为此构造 Logo Injector,并同时优化两个方向的相似度,既要保留原始 Prompt 的语义,又要保留 Logo 的信息。
最后Poisoned Embedding--->Prompt Recoverer---->Poisoned Prompt
攻击者再把这个 Prompt 发给系统,让它进入Approximate Cache
接下来最有意思的事情发生了
受害者正常输入,A beautiful modern street at night
他的 Prompt 里根本没有跟攻击者留下的投毒prompt相同的内容
但因为语义和攻击者留下的 Poisoned Prompt 足够接近:

结果图片里,可能出现攻击者提前植入的 Logo
论文明确描述,当正常用户命中 poisoned prompt 时,即使自己的 Prompt 中没有提到对应 Logo,最终输出也可能显示同样的 Logo
下面是实验复现结果

本次实验的 benign victim prompt 为 highly detailed digital painting of a medieval knight with angel wings in a forest
攻击者构造的 poisoned prompt 为 highly detailed digital painting of a medieval knight with angel wings in a forest, a huge Apple sign
而 受害者prompt 本身完全没有包含 Apple,截图中的自动视觉检测结果为:
Selected poison seed OWL score : 0.7100
Baseline OWL score : 0.0622
Poisoned victim OWL score : 0.4677
OWL score increase : +0.4055这里最关键的是:
Baseline:
0.0622
Victim after poisoned cache:
0.4677也就是说,在 victim prompt 完全没有指定 Apple sign 的情况下,命中攻击者的 poisoned cache 后,输出图像中的 Apple sign 检测分数显著提高
这说明攻击者能够通过 poisoned prompt 将自己的视觉内容写入 approximate cache;之后其他正常用户命中该 cache 时,其生成结果会继承攻击者注入的内容
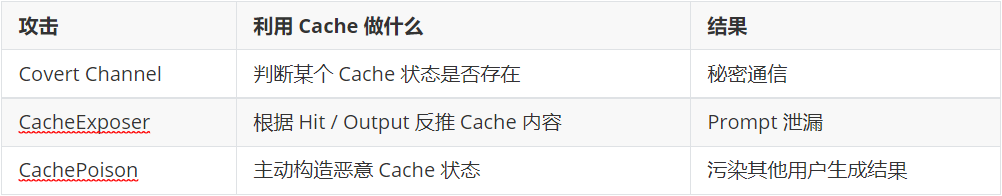
其实说是可以有三种攻击,但是其实它们实际上来自同一个根本问题
也就是不同用户之间原本应该彼此隔离,但是为了性能,共享了某种Intermediate State,而攻击者可以观察它甚至是影响它,再加上其他用户又会复用它,这就
会导致安全问题,毕竟观察它就可以泄露信息,修改它就可以影响别人,判断它存不存在就可以建立通信,如果说从这个角度来看的话,这三种攻击方式其实只是
这个共享状态安全问题的三个不同表现
本课程最终解释权归蚁景网安学院
本页面信息仅供参考,请扫码咨询客服了解本课程最新内容和活动